2026 年 10 月三大旗舰同台:GPT-6.1 Sol 打性价比与 Agent,Claude Opus 5.5 打复杂工程,Gemini 4 Argon 打长流程专业任务。本文用价格、上下文、场景三张表给出选型与组合路由建议。
相关工具选择
一句话结论
没有全能冠军,只有分工:
- 要性价比与 Agent 工具链 → GPT-6.1 Sol
- 要复杂工程与长程编码 → Claude Opus 5.5
- 要长流程专业任务与超长输出 → Gemini 4 Argon
三家最新一代的价格、上下文与强项,可以先用一张表看完:
| 维度 | GPT-6.1 Sol | Claude Opus 5.5 | Gemini 4 Argon |
|---|---|---|---|
| 发布时间 | 9 月 29 日 | 9 月 22 日 | 10 月 14 日 |
| 定位 | 接近旗舰、成本 1/5 | 前沿能力、成本优化 | 长流程专业任务 |
| 输入价格 | $2 / 百万 token | 约为 Argon 促销价 2 倍 | $2(11-30 前限时) |
| 上下文 | 继承 GPT-6 世代 | 以官方文档为准 | 100 万统一预算 |
| 最强项 | Agent / 性价比 | 复杂工程 / 长程编码 | 长输出 / 专业任务 |
| 明显短板 | 上限不如 Astra | 价格偏高 | 终端类基准落后 |
这三个月发生了什么
理解选型,先理解时间线——三家的节奏完全不同:
| 时间 | OpenAI | Anthropic | |
|---|---|---|---|
| 9 月初 | GPT-6 发布,旗舰 Astra | Fable 5.1 / Mythos 5.1 | — |
| 9 月中 | — | Cowork 全量 | — |
| 9 月下 | 6.1 Astra 取消;6.1 Sol 发布 | Opus 5.5、Sonnet 5.5 | — |
| 10 月上 | Sol Ultrafast 上线 | Haiku 5.5 | Gemini 4 Argon |
| 10 月下 | — | Claude Duet 预览 | Argon 全量开放 |
两件事值得记住:
- OpenAI 主动放弃了更强的 6.1 Astra(官方称「频繁忽略指令」),改用便宜 5 倍的 Sol 顶上——这是「稳定性优先」的信号。
- Google 用 10 月中旬的一次发布直接改了对比格局:Argon 在专业任务榜登顶,但工程基准并非全面领先。
分项对照
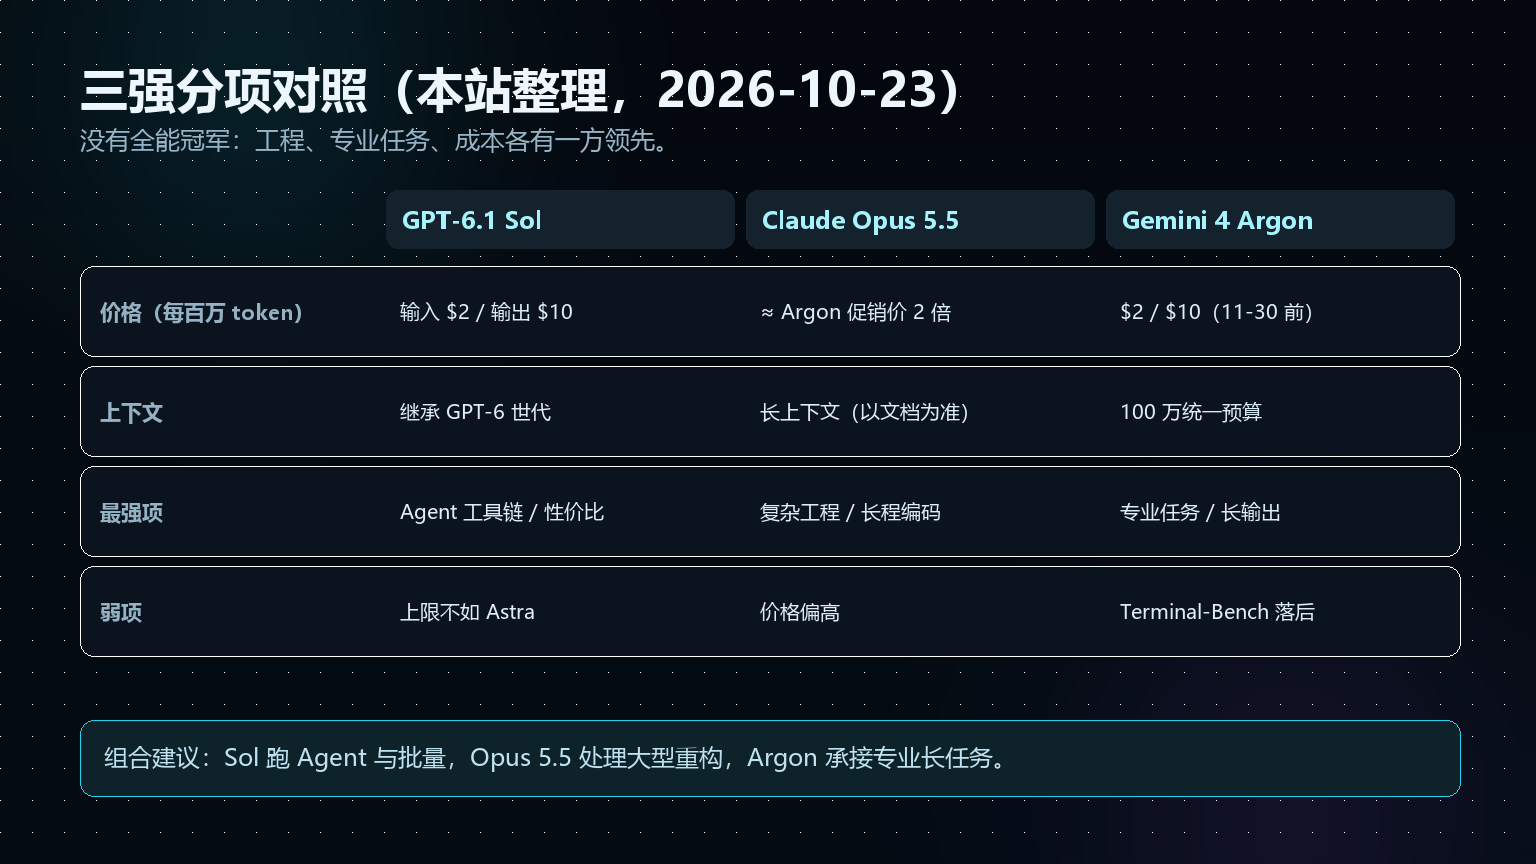
价格:Sol 与 Argon 同价,但窗口不同
- GPT-6.1 Sol:输入 $2 / 输出 $10,缓存输入 $0.10
- Gemini 4 Argon:输入 $2 / 输出 $10,仅到 11 月 30 日,之后翻倍
- Claude Opus 5.5:约为 Argon 促销价的两倍,属于「贵但稳」
关键差异不是单价,而是价格的有效期。 把 Argon 的促销价当长期成本,是最容易犯的预算错误。
上下文:Argon 的结构最特别
- Argon 是 100 万 token 统一预算:输入、思考、输出共用一份额度
- GPT-6 Astra 是 105 万上下文、12.8 万输出
- Claude 5.5 的长上下文能力以官方文档为准
统一预算的好处是不会「输入塞满、输出没地方」;代价是要主动管理额度,别把整本资料当提示词。
工程:Opus 5.5 与 Sol 分工
- Opus 5.5:跨文件重构、系统设计、需要严格约束遵循的长任务
- Sol:连续工具调用、多步骤自动化,成本允许你多跑几轮
- Argon:DeepSWE v1.1 上 77.9% 领先,但 Terminal-Bench 4.0 落后
换句话说:写代码这件事,三家都能做,差别在「谁更不容易跑偏」。
专业任务:Argon 的主场
Vals Index(按行业 GDP 加权的专业任务榜)上,Argon 68.9% 第一,Claude Sonnet 5.5 67.04%、Opus 5.5 66.97% 紧随。
这类任务的特征是:材料长、约束多、错一次代价高。金融、法律、税务、科研都属于这一类。
中文:三家差距在缩小
三家的中文能力都足够处理日常工作,差异更多体现在:
- 长中文材料的结构保持(Argon 与 Opus 5.5 更稳)
- 中文口语化改写与本地表达(Sonnet 5.5、Sol 更自然)
- 中文专业术语一致性(需在提示词里给术语表)
五个场景怎么选
| 场景 | 首选 | 备选 | 理由 |
|---|---|---|---|
| 日常编码、脚本、排错 | GPT-6.1 Sol | Sonnet 5.5 | 成本低、工具链顺 |
| 大型重构、架构设计 | Claude Opus 5.5 | GPT-6 Astra | 约束遵循与长程一致性 |
| 长卷宗 / 长报告 / 科研 | Gemini 4 Argon | GPT-6 Astra | 统一预算 + 长输出 |
| Agent 自动化、批量任务 | GPT-6.1 Sol | Haiku 5.5 | 单价低、可多轮重试 |
| 多模态理解与 UI 还原 | Gemini 4 Argon | GPT-6 Astra | 图文视频理解 |
组合路由:别只用一个模型
多数团队的最优解不是「选一个」,而是「按任务路由」:
| 环节 | 用谁 | 为什么 |
|---|---|---|
| 需求梳理、拆任务 | Sol 或 Sonnet 5.5 | 便宜、够快 |
| 核心实现 | Opus 5.5 | 一次做对,减少返工 |
| 长材料分析 | Argon | 长上下文 + 长输出 |
| 批量处理 | Haiku 5.5 或 Luna | 成本优先 |
| 终稿校验 | 与生成不同的另一家 | 交叉检查,降低同源错误 |
交叉校验这一条最容易被忽略:用 A 生成、用 B 复核,比让同一个模型自查更容易发现问题。
国内怎么用上这三家
| 模型 | 中文版入口 | 官方 |
|---|---|---|
| GPT-6.1 Sol | Luck AI | chatgpt.com |
| Claude Opus 5.5 | Luck AI | claude.ai |
| Gemini 4 Argon | Luck AI | gemini.google.com |
三步做同题对照:
- 准备同一份材料:一段真实代码、一份长文档,或 20 条用户反馈。
- 同一提示词跑三家:只换模型,不换提示词。
- 记录四项:一次可用率、返工轮数、耗时、花费。
第三方入口仅供体验;账号、订阅与支付以各家官方为准。本站与 OpenAI、Anthropic、Google 均无关联。
15 分钟对照实验
三家跑完后,按这个顺序判断:
- 谁能一次给出可直接用的结果
- 谁的约束遵循最稳(没加戏、没漏项)
- 谁的花费在可接受范围内
通常结论会是:日常任务三家都能过,差距出现在「长」和「难」上。
三个常见误区
误区一:等一个「全能冠军」
三家的强项几乎不重叠,等下去只会继续用旧模型。正确做法是按任务分派。
误区二:只看榜单第一名
榜单测的是别人的任务。Vals Index 第一不等于你的场景第一,Terminal-Bench 落后也不代表不能用。
误区三:忽略价格有效期
Argon 的 $2 是限时价,11 月 30 日后翻倍;Sol 的缓存价 $0.10 也要靠固定提示词才能吃到。不设计缓存,就等于没享受到折扣。
常见问题 FAQ
三家只能选一个,选谁?
日常与 Agent 选 GPT-6.1 Sol;复杂工程选 Claude Opus 5.5;长流程专业任务选 Gemini 4 Argon。没有单一答案。
中文场景哪家更好?
差距不大。长中文材料看 Argon / Opus 5.5,口语化改写看 Sonnet 5.5 / Sol,专业术语要靠提示词约束。
价格最便宜的是谁?
当前 Sol 与 Argon 同为 $2 输入;但 Argon 是限时价,11 月 30 日后翻倍。批量场景可看 Haiku 5.5。
为什么 GPT-6.1 Astra 没发?
官方称其在测试中「频繁忽略指令」,发布前一天被放弃,改用 Sol 顶上。详见:ChatGPT 最新模型版本。
要不要同时订三家?
个人用户没必要。建议「一家主力 + 一家备选」,用交叉校验解决质量问题,成本更可控。
相关阅读
- ChatGPT 最新模型版本:GPT-6.1 Sol vs GPT-6 Astra
- Claude 5.5 三档完整指南
- Gemini 4 Argon 官网入口与国内使用
- ChatGPT vs Claude vs Gemini:三大场景怎么选
结语
2026 年秋天的这轮更新,把「选模型」从「谁最强」变成了「谁更适合这一步」。
Sol 负责跑量,Opus 5.5 负责攻坚,Argon 负责长任务。 把这三句话落到你的工作流里,比继续等一个全能冠军有用得多。